数据不出内网、成本可控、还能按业务定制——企业自建大模型服务器正从"大厂专利"变成"中型企业可选项"。本文给技术决策者一份能照着打的底稿:买什么、怎么装、花多少、用在哪。
引言:当"上云"不再是唯一答案
过去两年,企业用大模型的第一反应都是"接个 API"。方便、便宜起步、不用操心硬件。但真正把 AI 跑进核心业务后,越来越多 CTO 发现三件扎心的事:
- 数据出不去:合同、财务、客户资料一旦送进公有云,合规压力陡增;
- 账单滚雪球:调用量上来后,API 费用按月指数级上涨;
- 调不动:通用模型改不了、私有知识融不进、响应还受限于别人的服务稳定性。
于是"在自己机房里放一台能跑大模型的专业服务器"重新回到议程。本文不鼓吹"必须自建",而是把什么时候该建、怎么建、建多强、花多少一次说清。
一、为什么要自建:四类企业最容易算回账
| 动因 | 典型表现 | 自建收益 |
|---|---|---|
| 数据合规 | 金融、医疗、政企,数据禁止出域 | 数据 100% 留内网 |
| 成本拐点 | 日均调用量大,API 年费 > 硬件折旧 | 边际成本趋近于 0 |
| 可控定制 | 要微调、要接私有知识库、要稳定 SLA | 自主迭代、不依赖第三方 |
| 离线可用 | 内网/隔离环境、出海弱网 | 断网也能用 |
结论:如果你只是偶尔用 AI 写写文案,云 API 足够;但如果 AI 已成生产系统一部分,且数据敏感或调用高频,自建的 TCO(总拥有成本)通常在 12–24 个月内反超云端。
二、硬件配置建议:GPU 是绝对核心
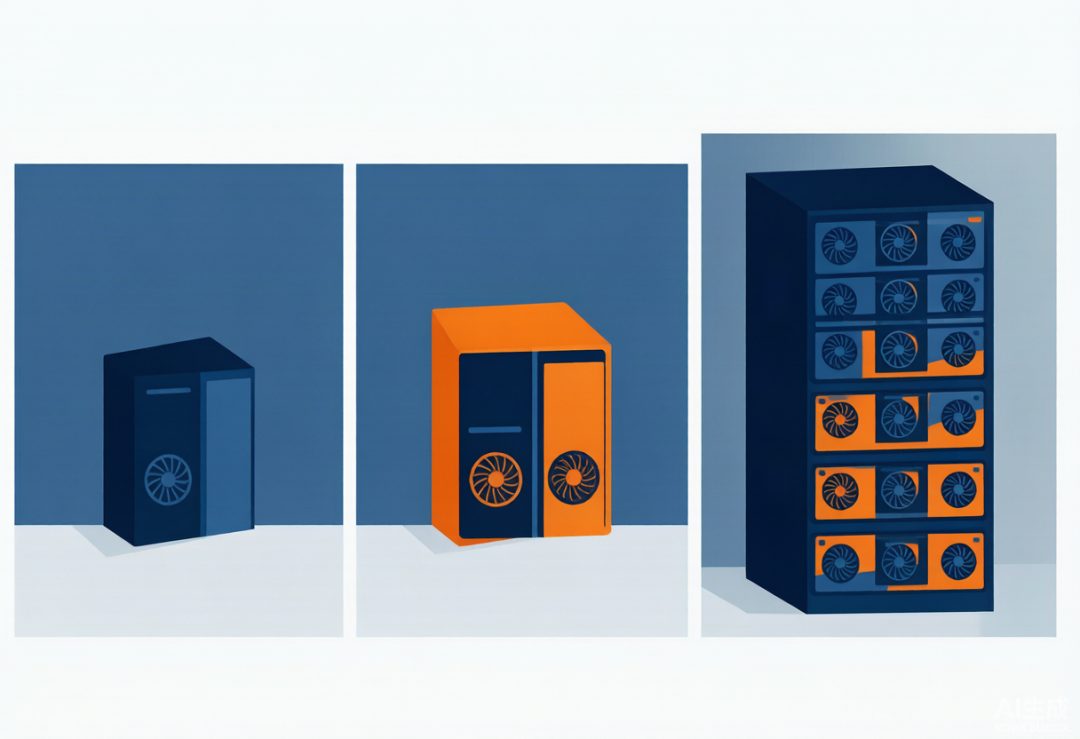
自建大模型的硬件里,GPU 决定你能跑多大的模型,其余都是为它服务的配角。下面按"入门—标准—旗舰"三档给建议。
2.1 GPU:显存即能力
模型参数规模直接换算成显存需求(以 4-bit 量化为例,最省显存的实用档):
| 模型规模 | 4-bit 量化显存 | 推荐最低显卡 |
|---|---|---|
| 7B(如 Qwen2.5-7B) | 约 5–6 GB | 单卡 24GB(RTX 4090/5090) |
| 14B | 约 9–11 GB | 单卡 24GB |
| 32B | 约 20–24 GB | 单卡 48GB(L20 / L40S) |
| 70B | 约 40–48 GB | 双卡 48GB 或单卡 80GB(A100/H100) |
| 满血 671B(DeepSeek-R1) | 数百 GB | 多卡 H100/H200 集群 |
选型梯度(2026 视角): - 入门 / 开发验证:RTX 4090(24GB)、RTX 5090(32GB)——消费级,性价比高,但无 NVLink、不适合多卡扩展,适合 POC; - 推理主力:NVIDIA L20(48GB,被动散热、数据中心优选)、L40S(48GB)——稳定 7×24,单卡可跑 32B、双卡跑 70B; - 微调 / 高并发:A100 80GB、H100 80GB(HBM3)、H200 141GB——训练与高吞吐推理; - 合规备选:华为昇腾 910B、寒武纪等国产卡——满足信创与供应链要求,但软件生态需单独适配。
2.2 CPU:喂得饱 GPU 就行
- 核心数:16–64 核,越多越利于数据预处理与多模型并发;
- 型号:Intel 至强(Xeon)可扩展系列、AMD EPYC;
- 注意:CPU 主要做"搬运与编排",不必追顶级,但 PCIe 通道数要够(多卡需 PCIe 4.0/5.0 ×16)。
2.3 内存:大模型的后备仓库
- 经验值:内存 ≥ GPU 显存总和的 1.5–2 倍;
- 例:双卡 48GB(共 96GB 显存)→ 配 192–256GB 内存,便于 CPU offload 与多模型常驻。
2.4 存储:模型文件很占地方
- 系统盘:1TB NVMe SSD;
- 模型盘:2–8TB NVMe SSD(一个 70B 量化模型约 40–50GB,满血模型数百 GB,需留余量);
- 备份盘:另挂企业级硬盘或 NAS,做模型与配置快照。
2.5 网络:多卡与远程调用的命脉
- 单机多卡:优先 NVLink / NVSwitch(卡间带宽远高于 PCIe);
- 多机扩展:InfiniBand 或 25/100GbE RoCE;
- 对外服务:内网千兆/万兆,对外经反向代理 + 鉴权暴露,禁开 0.0.0.0 公网直连。
2.6 三档配置速查(直接抄)
| 档位 | GPU | 内存 | 存储 | 能跑什么 | 参考定位 |
|---|---|---|---|---|---|
| 入门 | 1× RTX 5090 32GB | 64GB | 2TB NVMe | 7B/14B 日常、POC | 验证期 / 小团队 |
| 标准 | 2× L20 48GB | 256GB | 4TB NVMe | 32B 流畅、70B 可用 | 部门级生产 |
| 旗舰 | 4–8× H100/H200 80GB | 512GB+ | 8TB+ NVMe | 70B 高并发、微调、满血可选 | 企业级平台 |
三、软件环境部署要点
硬件到位只是开始,软件栈决定"好不好用"。
- 底层驱动:安装 NVIDIA 驱动 + CUDA Toolkit(版本需与推理框架匹配);
- 推理框架(按场景选): - Ollama:最易上手,单机本地模型管理首选; - vLLM / SGLang:高并发、批处理、吞吐优化,适合对内服务; - llama.cpp:CPU/GPU 混合、量化友好、跨平台;
- 模型格式:GGUF(llama.cpp)、GPTQ / AWQ(4-bit 量化,省显存);
- 编排与智能体:可用 DeepSeek Harness 等框架把"模型 + 知识库 + 工具调用"串成 Agent,实现文档处理、问答等办公自动化;
- 安全暴露:用 Nginx 反向代理 + API Key 鉴权,限内网或 VPN 访问,切勿
--host 0.0.0.0直连公网; - 可观测:接监控(GPU 利用率、显存、请求延迟),设告警。
四、成本与运维考量
4.1 成本三块
- 一次性硬件:入门约数万、标准约十万级、旗舰数十万到百万级;
- 电费与机房:旗舰机满负荷月电费可观,需算进 TCO;
- 运维人力:至少 0.5–1 名兼职工程,负责升级、排障、安全补丁。
4.2 云 vs 自建 TCO 拐点
调用量低 → 云便宜;调用量高且持续 → 自建折旧摊薄后边际成本趋零。经验拐点:当月 API 费用稳定超过硬件月折旧(约总价/36)时,自建开始划算。
4.3 运维红线
- 散热与供电:GPU 高功耗,机房空调与 UPS 要匹配;
- 备份:模型权重 + 配置文件定期快照,防损坏;
- 安全:及时打驱动/CVE 补丁,限制访问来源;
- 升级:框架与模型版本迭代快,留好回滚方案。
五、典型应用场景
- 私有知识库问答:把制度、手册、项目文档喂进本地模型,员工内网问、数据不出门;
- 文档处理与智能写作:合同摘要、报告生成、周报起草,敏感内容不外流;
- 代码助手:本地代码补全与审查,源代码不离开内网;
- 智能客服:结合业务知识库的本地客服机器人;
- 数据分析:上传表格让模型做初步解读与可视化建议。
六、落地建议:三步走
- 先验证:用入门配置 + Ollama 跑通一个真实场景(如知识库问答),两周内出 demo;
- 再定档:按 demo 的并发与模型规模,对照第二章三档表选标准/旗舰;
- 后治理:接入监控、鉴权、备份,定 SLA,再逐步扩场景。
如果你正评估"我们到底要不要自建、建多强",莱驰云AI 可提供企业 AI 应用诊断、AI 培训、AI 解决方案设计三项支持,帮你按数据敏感度、预算与并发,定下最合适的配置档位与落地路径。
回复【配置】免费领《企业自建大模型服务器配置清单》(三档硬件速查 + 软件部署核对 + 成本年表)。
参考:NVIDIA、AMD 及各大模型厂商公开硬件指南;推理框架(Ollama / vLLM)官方文档。具体参数随产品代际迭代,以官方最新规格为准。