一份把 Harness 从"能聊天的 AI"升级成"全员办公底座"的实操清单。
数据口径:DeepSeek Harness 官方文档(截至 2026-08,开发者预览版 v0.1.x,MIT 开源)。
装上 npx @deepseek-ai/dsh web,你能得到的只是 http://127.0.0.1:3080 的一个本地 Web UI。它默认只听本机回环地址,连 ChatGPT 的聊天能力都称不上,更别说覆盖办公场景。
要把 Harness 真正用进日常办公,必须装一组插件。
原因很简单——DeepSeek Harness 的官方设计哲学叫「一切皆插件」:模型、工具、技能、会话、沙箱、存储、调度、UI,全是 Cordis 插件组合出来的。框架本身只有一个空的插件骨架,真正的能力来自你往里挂什么。这篇文章就按"办公必装"的颗粒度,把插件清单拆成三层讲清楚。
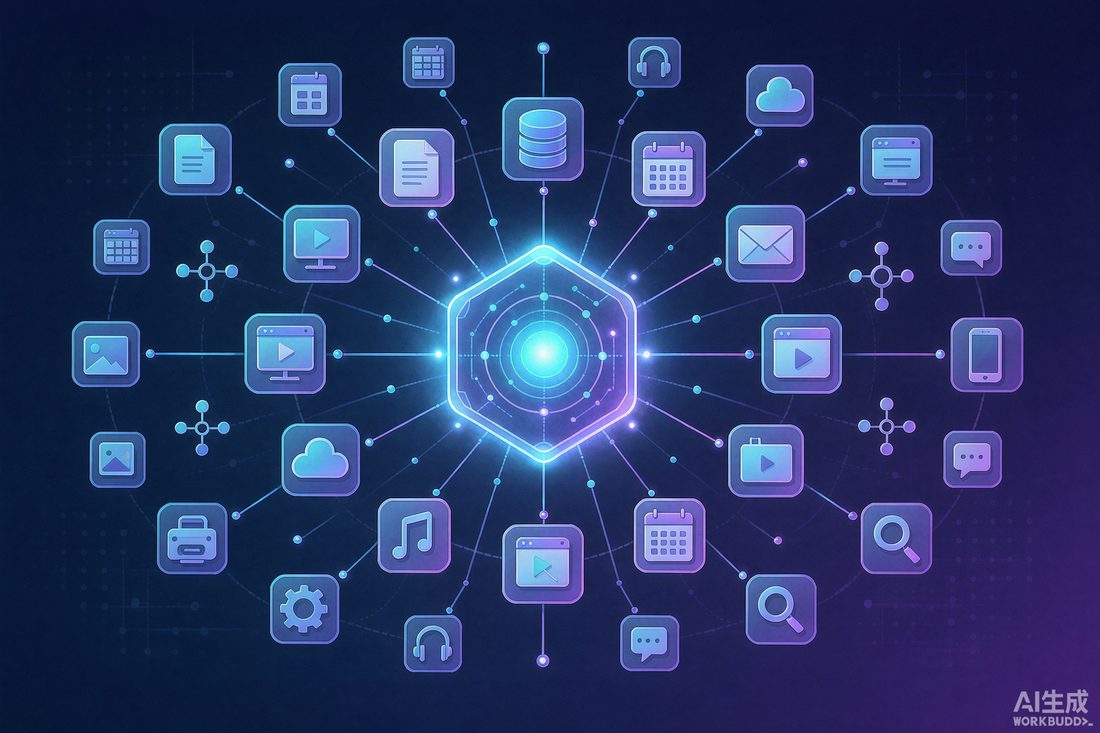
一、一张图看懂 Harness 的插件体系
把 Harness 想象成中间那个发光节点,周围一圈办公工具图标(文件、数据库、日历、邮件、浏览器、表格……)通过插件连进来。这是 Harness 的典型工作方式:插件即四肢,挂得越多,能干的事越多。
围绕这个中心,我把办公场景下"配合 Harness 使用"的插件分成三层:
| 层级 | 含义 | 关键问题 |
|---|---|---|
| 第一层 · Harness 原生插件 | 直接扩展 Harness 本身的能力(Cordis 插件) | 让 Harness 能"动手",不只是"动嘴" |
| 第二层 · 模型接入 providers | Harness 用什么模型的后端 | 决定成本、合规、能力上限 |
| 第三层 · 办公协同客户端 | 与 Harness 并行、直接接模型后端的周边工具 | 补齐浏览器、IDE、知识库、IM 等入口 |
下面一层一层讲。
二、第一层 · Harness 原生插件(办公自动化核心)
这一层是"让 Harness 从问答变执行"的关键。共 5 个推荐,其中前 3 个是办公场景的必装。
2.1 MCP 客户端插件(内置,/mcp)——办公自动化第一件必装
功能定位:Harness 内置官方 MCP(Model Context Protocol)客户端,提供 /mcp 命令与 Settings → MCP 服务器配置面板。你可以把任意 MCP 服务器挂进 Harness,让模型直接调用。
适用场景: - 读项目里的合同、报价单、图纸 PDF - 查公司内部数据库/CRM/工单系统 - 操作日历、邮件、GitHub、企业微信素材库 - 让 Harness 自动填表、写周报、提交工单
实际价值:把"会聊天的 AI"变成"能动手的办公助手"。这是单一投入回报最高的插件——只要挂上文件系统和数据库 MCP,你日常 60% 的查询/整理工作就能让 Harness 干。
💡 MCP 是 Anthropic 提出的开放协议,生态里已有大量现成 server(文件系统、SQLite、Playwright 浏览器、GitHub 等),无需自己写。
2.2 记忆与持久化插件(社区)——让 Harness 越用越懂你
功能定位:社区已涌现一批记忆类 Cordis 插件:知识图谱记忆、SQLite 持久化存储、本地优先 Agent 记忆等。它们让 Harness 跨会话记住你的项目背景、术语表、历史决策、用户偏好。
适用场景: - 长期跟进的客户/项目(记得上次讨论过的痛点) - 重复性工作(报价、合同、合规条款) - 多人协作(团队共享一套项目上下文)
实际价值:Harness 默认每次会话是孤立的——关掉就没了。挂上记忆插件后,AI 能跨周、跨月、跨项目累积上下文,第二周的工作效率比第一周高一倍。对工程咨询、投标这类长期项目尤其关键。
2.3 本地 AI 工作台(社区 Electron 桌面端)——给团队一个图形化入口
功能定位:社区已发布一款本地优先的 AI 工作台桌面应用(基于 Electron),把 Harness 的会话、项目文件、数据分析、网页研究、MCP、Office 产物聚合到一个图形化窗口。非开发者同事不用敲命令就能用上 Harness。
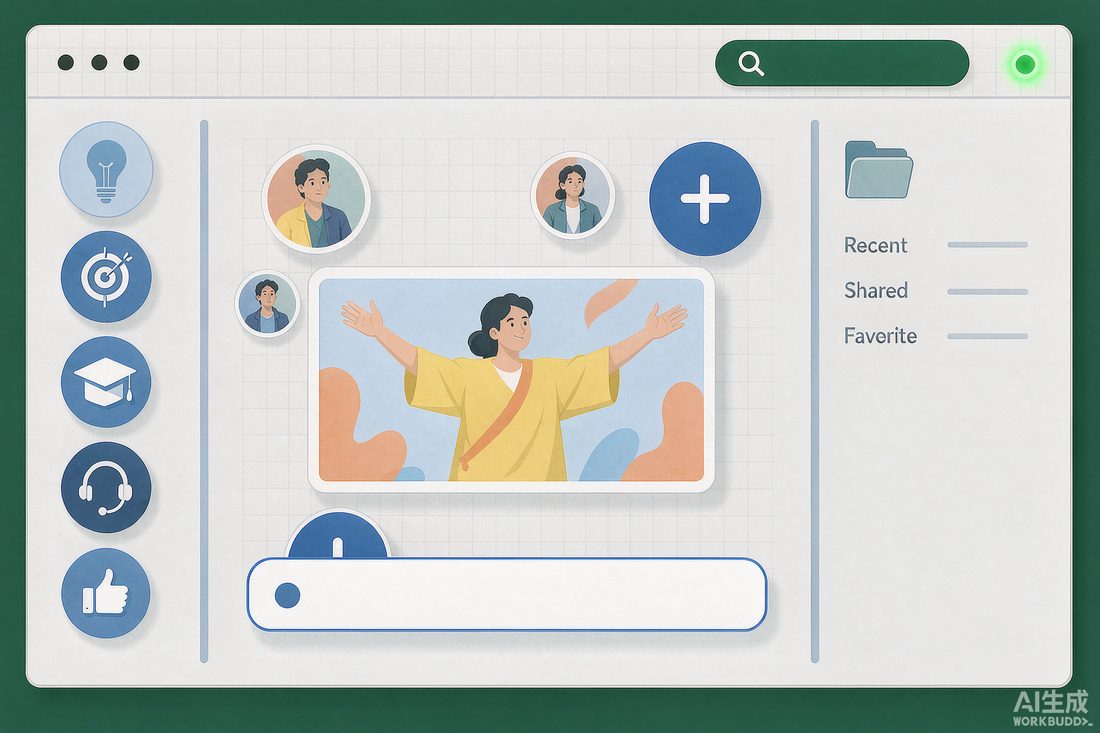
适用场景: - 非技术岗位(销售、行政、运营)也想用 Harness - 团队共享一套 Harness 环境,避免每人装 Node.js - 需要把 Harness 的产出(文档、表格、图表)直接落地到 Office 文件
实际价值:把 Harness 从"开发者玩具"变成"全员工具"。一个工程师搭好工作台,全部门都能用——这是 AI 在企业内规模化的最短路径。
2.4 dsh-chatgpt-bridge(社区)——双生态桥接
功能定位:把 Harness 会话作为 MCP 服务器暴露给 ChatGPT(以及任何支持 MCP 的客户端),让你在 ChatGPT 的界面里调用 Harness 的工具与本地数据。
适用场景: - 团队已习惯用 ChatGPT 网页版/桌面版,希望保留入口 - 想在 ChatGPT 里直接调 Harness 挂的文件系统/数据库 MCP - ChatGPT 会员用户想兼顾订阅模型的体验和 Harness 的本地工具
实际价值:不强迫团队切换前端,把 Harness 的能力注入到既有 ChatGPT 工作流,降低推广阻力。
2.5 自研业务插件(Tool / MCP / LLM Adapter 三选一)——把公司系统接进来
Harness 官方架构定义了三种扩展接缝,自研插件必须三选一,不能混用:
| 接缝 | 适用场景 | 关键约束 |
|---|---|---|
| Tool | 本进程内的本地能力(TypeScript,同 Cordis 生命周期) | 必须返回规范 JSON,遵守沙箱/授权策略 |
| MCP Client | 远程已暴露 MCP 协议的服务器 | 一个 server 一个插件实例,Tools only(Resources/Prompts 仅桥接) |
| LLM Adapter | 新的模型提供商协议 | 负责路由、流顺序、错误、用量、回放元数据 |
实际价值:把你公司的 ERP / CRM / OA / 内部知识库封装成 Tool 或 MCP server 挂进 Harness,打通最后一公里的数据孤岛。这一步通常是企业落地 AI 真正的价值分水岭。
三、第二层 · 模型接入 providers(决定 Harness 用谁)
Harness 是"BYO Model"(自带模型)模式——框架本身不绑定模型,通过 ~/.dsh/settings.yaml 里的 llm-pi-ai.providers 字段接入 40+ 提供方。
办公场景下,按"成本 × 合规 × 能力"三轴选 provider:
3.1 云端国产合规模型(推荐默认)
| Provider | Base URL(/v1) |
协议 | 适合 |
|---|---|---|---|
| DeepSeek 官方 | DeepSeek 平台 baseURL |
openai-completions |
默认首选,能力强、价格低 |
| 阿里云百炼 | https://<WorkspaceId>.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1 |
openai-completions |
国产合规、Token Plan/Coding Plan |
| 字节方舟 Coding Plan | https://ark.ap-southeast.bytepluses.com/api/coding/v3 |
openai-completions |
字节生态企业 |
配置示例(~/.dsh/settings.yaml):
agent-default-model:
  provider: bailian
  model: qwen3.8-max

llm-pi-ai:
  providers:
    bailian:
      api: openai-completions
      baseURL: https://<WorkspaceId>.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1
      apiKeyEnv: BAILIAN_API_KEY
      models:
        - id: qwen3.8-max
⚠️ Web UI → Settings → Models → Add a custom provider 是新手最稳的路径;YAML 字段名在开发者预览期可能变化,以当前 UI 写入的版本为准。
3.2 本地推理 Ollama / vLLM(数据敏感场景)
如果客户合同、内部文档绝对不能出域,挂本地 Ollama(localhost:11434)或 vLLM(localhost:8000)作为 provider,端点填成对应 /v1 地址。Harness 不感知差异,对你来说就是"换个 baseURL"。
3.3 聚合网关(OpenRouter / LiteLLM / One API)
把多家的 key 集中在一个兼容端点后面,Harness 只配一次 provider,就能在模型选择器里切不同模型。适合既要国产合规、又要国际模型能力的混合场景。
四、第三层 · 办公协同客户端(共用模型后端,构成完整栈)
下面这些不是 Harness 的插件——它们直接连模型后端(也就是第二层的 provider 端点),与 Harness 并行。但办公场景下,你大概率会同时部署它们,构成完整的 AI 办公栈。表格按场景速配,不展开讲具体配置:
| 客户端 | 形态 | 怎么挂上模型后端 | 办公价值 |
|---|---|---|---|
| 沉浸式翻译 | 浏览器扩展 | 设置 → 翻译服务 → 添加 OpenAI 兼容服务 → 填 /v1/chat/completions 完整路径 |
外文网页、PDF、技术文档一键翻译 |
| Open WebUI | 自托管 Web 聊天(Docker) | 安装时配 OLLAMA_BASE_URL 或通用 OpenAI endpoint |
给不会用 Harness 的同事一个聊天界面 |
| AnythingLLM | 桌面/Docker 工作台 | 设置 → LLM Provider → Generic OpenAI → 填 BaseURL/Key/Model | 企业知识库 + RAG + 多工作区 |
| Continue | VS Code / JetBrains 插件 | config.json 或 config.yaml 配 provider: openai + apiBase |
IDE 内 AI 编程助手 |
| 企微/飞书/钉钉 Bot | IM 机器人 | 自建应用回调 → 桥接服务 → 调 Harness 或直调模型 | 全员在 IM 内用 AI(详见本号上篇) |
重点:沉浸式翻译(最受办公人欢迎)
功能定位:浏览器扩展,双对照翻译外文网页与 PDF。
必装理由: - 支持自定义 OpenAI 兼容端点(不是只能绑官方),可挂你的 DeepSeek/百炼 provider - 同时翻译 + 保留原文排版,阅读技术文档、英文论文、海外厂商手册必备 - 可"点哪段译哪段",不打断阅读节奏
实际价值:工程、研发、商务岗每天人均省 30–60 分钟在外文资料阅读上。
重点:AnythingLLM(企业知识库首选)
功能定位:把公司文档(PDF、Word、Excel、网页)上传到 workspace,自动向量化,对话式检索。
必装理由: - Generic OpenAI 提供商——任何兼容端点都能挂(DeepSeek/百炼/本地 Ollama) - 多 workspace 隔离,不同部门不同项目不同知识库 - 桌面版开箱即用,无需部署 Docker
实际价值:把 5 年沉淀的项目文档变成"问就答"的内部 ChatGPT。投标、客服、培训场景 ROI 立竿见影。
五、插件怎么装、怎么管
5.1 安装命令(pnpm 透传)
dsh plugin 把操作转发给 pnpm,支持 npm 包、GitHub spec、本地路径(link:、file:)等所有 pnpm 源:
# 加一个 npm 插件到 web profile
dsh plugin --profile web add "<plugin-package>"

# 从本地开发链接加
dsh plugin --profile web add "link:$(pwd)"

# 重新跑同样命令 = 升级
5.2 看实际生效的插件树
dsh --profile web --dump-config
任何一行你都能用自己的补丁覆盖。Harness 没有需要打补丁的特权核心——所有组件都可换。
5.3 三层补丁叠加
- Bundle:上游分发的补丁单元
- Profile(
~/.dsh/profiles/):命名组合 - 个人补丁(
~/.dsh/cordis.patch.yml):你自己的覆盖层,永远最后加载
5.4 关键安全与版本纪律
| 纪律 | 原因 |
|---|---|
| 固定版本(pin) | 开发者预览期,核心插件和 API 会快速迭代,rc 版本间可能不兼容 |
密钥放 ~/.dsh/.credentials.yaml,mode 600 |
stat -c '%a %n' 检查,群组可读=泄露给同机所有账号 |
Web UI 只听 127.0.0.1:3080(loopback) |
公网直开 3080 等于把 API 暴露给全网;远程访问请用 SSH 隧道 ssh -N -L 3080:127.0.0.1:3080 |
apiKeyEnv 从 dsh 进程环境读 |
systemd 等服务环境与登录 shell 不同,会出现"手动能跑、服务起不来"的 MISSING_CREDENTIAL |
六、办公落地 · 8 项避坑清单
- Node 版本必须是 22.19+ 或 24+(22 行内、23 不行);不匹配会在启动时报错像包坏了。
- 不要硬编 settings.yaml 字段名——开发者预览期嵌套结构最易变;先在 Web UI 里加一遍 provider,再打开
settings.yaml复制它写出的结构。 apiKeyEnv引用的是 dsh 进程环境,不是你的 shell;systemd unit 必须显式Environment=BAILIAN_API_KEY=...。- 多 provider 共存时 Provider ID 不可改(创建后想改名只能删了重建);起名要稳。
- 多模态模型要在 settings.yaml 里手动加
input: [text, image],否则默认只吃文本。 modelID 必须跟 provider 端完全一致(有些平台格式供应商/模型名,省略前缀会 404)。- 同一时间只跑一个 dsh web(默认端口 3080);换端口用
dsh web --port 8080,别忘了同步下游桥接服务。 - 本地优先 ≠ 离线可用——本地 Ollama/vLLM 也要联网拉模型权重;首次
pull模型注意磁盘。
七、最后说两句
DeepSeek Harness 处于开发者预览期,核心 API 会迭代,别把它当生产依赖,但它的"一切皆插件"设计是真的——这是它和大多数 Agent 框架最本质的区别。
办公场景下的优先级,我建议这么排:
- 先把 MCP 客户端 + 文件系统/数据库 MCP server 装上(60% 的提效来自这里)
- 再加记忆/持久化插件(让 AI 越用越懂)
- 选一个模型 provider(默认建议阿里百炼或 DeepSeek 官方)
- 最后根据团队情况上本地工作台 / 沉浸式翻译 / AnythingLLM / Continue
把这套装齐,Harness 才算从"装上即放弃"变成"全员在用"。
📌 下一篇预告:《DeepSeek Harness 接入飞书,让全员在群里飞书 AI 助手》——飞书的开放接口和企业微信大同小异但更"开发者友好",是中小团队的更优选。
如需本文配套的「DeepSeek Harness 办公插件选型清单」checklist(Markdown 版,含每个插件的安装命令、版本号、依赖关系),关注本号并回复关键词 【插件】 获取。