面向公众的技术科普。本文聚焦「工程可行性」,不讨论立场,只讲清楚:在先进 AI 芯片出口受控的背景下,基于华为 CANN(昇腾)或其他国产 GPU/NPU 运行大模型,到底行不行、强在哪、难在哪、未来会怎样。文中性能数字为公开资料整理的量级参考,非精确基准测试。
一、背景引入:为什么这个问题会被提出来
大模型(如大家熟知的 DeepSeek、通义千问、ChatGLM 等)本质是「吃算力」的应用。训练一个千亿、万亿参数的模型,需要成千上万张高端 AI 加速卡长时间并行工作;即便只是把训练好的模型部署上线供用户使用(业内叫「推理」),也需要相当可观的算力支撑。
过去多年,全球最主流的 AI 加速卡几乎都来自英伟达(NVIDIA),其背后的 CUDA 软件生态更是事实标准。然而自 2022 年起,美国通过商务部工业与安全局(BIS)的「先进计算芯片」出口管制规则,逐步限制对华出口高性能 AI 芯片:
- 2022 年 10 月:A100、H100 被列入禁售;
- 2023 年 10 月:为绕开限制而推出的「中国特供版」A800、H800 也被纳入管控;
- 2024—2025 年:管制持续收紧,扩展到高带宽存储(HBM)、EDA 工具与相关制造设备;
- 2025 年至今:H20(性能约为 H100 三分之一的降级芯片)一度被禁又恢复许可,H200 改为「逐案审查」的许可管理,而 H100、B200/GB200 等最顶级训练芯片至今仍严格禁止对华出口。2026 年虽批准约十家中国头部企业有限采购 H200(每家企业有数量上限),但相对于年需求量仍是「紧平衡」。
于是,一个现实问题摆在国内企业与开发者面前:买不到最先进的进口卡,我们自己的硬件能不能顶上? 这正是本文要回答的。
二、技术可行性分析:能不能跑?怎么跑?
2.1 先认识 CANN 与「昇腾」
CANN(Compute Architecture for Neural Networks,异构计算架构) 是华为为自家的「昇腾(Ascend)」NPU 打造的全栈计算架构,常被类比为「华为版的 CUDA」。它处在硬件之上、应用之下,负责把上层框架的神经网络计算,翻译成昇腾芯片能执行的具体指令。
一台基于昇腾的服务器(如 Atlas 800I A2,内置 8 张昇腾 910B)其软件栈大致是这样一层层叠起来的:
应用层:   transformers / LangChain / 自研业务
推理引擎: torch_npu | MindIE | vLLM-Ascend | MindSpore
计算架构: CANN(算子库 / 编译器 / 运行时)
驱动固件: NPU 驱动 | 固件
硬件层:   昇腾 910B / 910C / 310 / 300I
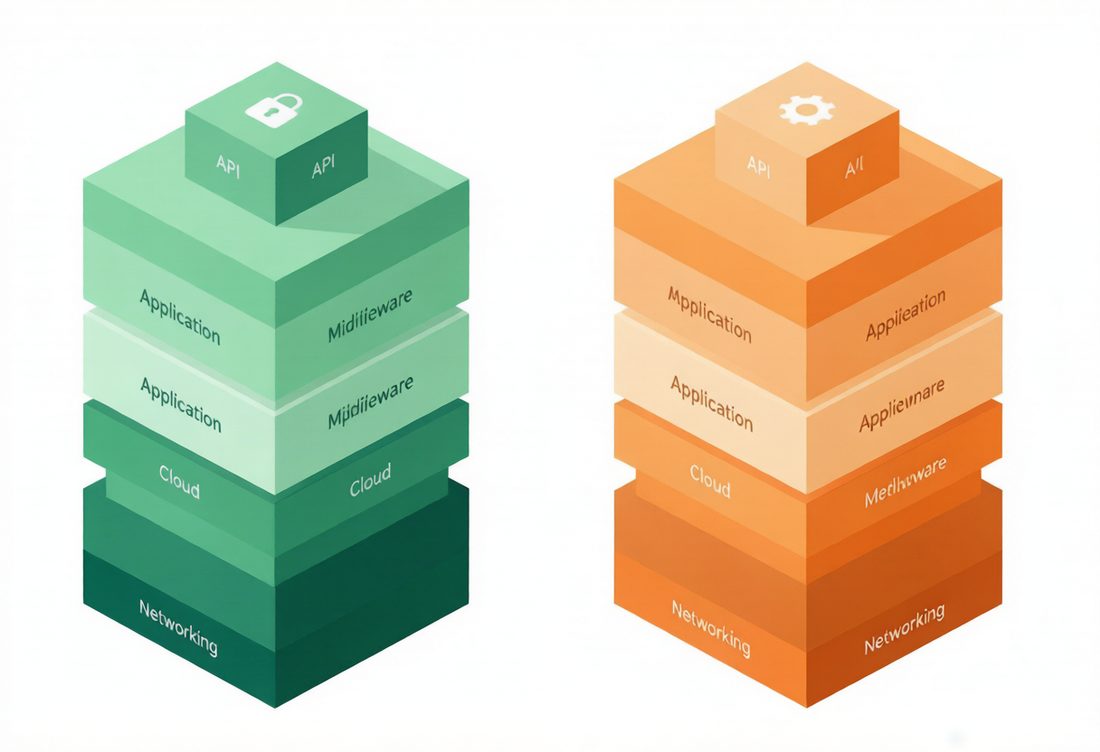
图:左为以 CUDA 为核心的国外主流技术栈,右为以 CANN 为核心的国产技术栈,二者形态相似,都是「框架 → 推理引擎 → 计算架构 → 驱动 → 硬件」的分层结构。
2.2 结论先行:能跑,而且已经有人跑通了
答案是肯定的。以当前生态成熟度看:
- 推理(部署上线)已相当成熟。华为官方与社区提供了 MindIE(面向大模型的高性能推理引擎,兼容 OpenAI API)、vLLM-Ascend(开源 vLLM 的昇腾适配版)、以及 torch_npu(让 PyTorch 模型几乎「改一行设备参数」就能在昇腾上跑)。主流开源模型如 DeepSeek、Qwen、Llama、ChatGLM、Baichuan 等均有昇腾适配版本。
- 训练也已可行。DeepSeek-R1(671B 满血版)已有在数十张乃至上百张昇腾 910B 组成多机集群上完成部署与训练的公开实践;华为云、天翼云等国内云平台也提供基于昇腾的算力租赁。
- 迁移成本分档:PyTorch 模型做推理,改动很小(约 1–2 天);做训练需适配部分算子(约 1–2 周);若原代码深度依赖自定义 CUDA 核函数,则需要用昇腾的 Ascend C 重写,工作量较大。
2.3 其他国产硬件路线
除了华为昇腾,国内还有多条并行路线,且多数已能适配主流大模型,尤其擅长推理:
| 厂商 / 产品 | 架构特点 | 定位 |
|---|---|---|
| 寒武纪(思元 590/370) | 自研 MLU 架构,云边端一体 | 云端推理、智能视觉 |
| 海光(DCU K100 系列) | 基于 AMD CDNA 思路,兼容 ROCm 生态,x86 路线 | 信创服务器、金融政务 |
| 壁仞(BR100) | Chiplet 异构设计,兼容 CUDA 生态思路 | 大规模训练/推理 |
| 燧原(云燧 T20/S60) | DTU 架构,软硬一体 | 互联网、金融 |
| 沐曦(曦云 C600) | 通用 GPU,FP8 原生,MXMACA 兼容 PyTorch/TF | 智算中心 |
| 摩尔线程(MTT S5000) | 全功能 GPU,率先支持 FP8 | 推理、数字孪生 |
| 天数智芯、昆仑芯、登临 等 | 各具特色的 GPGPU / 加速卡 | 推理为主 |
行业观察(如摩根士丹利 2025 年底调研)指出:中国 AI 计算的重心正从「训练端」加速转向「推理端」,而在推理场景下,多款国产卡已可平替消费级进口卡(如 RTX 4090),且成本更具优势。
2.4 性能到底差多少?(量级参考)
下面的对比取自公开资料整理,仅为量级示意,不代表任何一次精确跑分:
| 指标(FP16 算力 / 显存 / 带宽) | 昇腾 910B | NVIDIA H100* | NVIDIA H20** |
|---|---|---|---|
| 单卡 FP16 算力 | ~320 TFLOPS | ~1979 TFLOPS | ~148 TFLOPS |
| 显存 | 64 GB HBM2e | 80 GB HBM3 | 96 GB HBM3 |
| 显存带宽 | ~1312 GB/s | ~3350 GB/s | ~4000 GB/s |
| 卡间互联 | HCCS ~392 GB/s | NVLink ~900 GB/s | NVLink ~900 GB/s |
H100 对华禁售;*H20 为受限许可下的降级型号,算力约为 H100 的 1/3,但带宽被刻意保留。
图:概念性示意——在「顶级训练算力」这一维度,当前国产旗舰与最先进进口卡仍有差距;但在推理与中大规模训练场景,国产硬件已可形成有效供给。具体数值请以实际测试为准。
三、优势与挑战:价值与局限都要说清楚
3.1 优势
- 供应链自主权,规避「许可不确定性」。国产硬件不受 BIS 许可约束,采购、交付、扩容节奏完全自主,不用担心某天突然被切断。
- 信创合规友好。对政务、金融、能源、国企等「自主可控」要求高的行业,国产硬件是刚需选项。
- 成本与可获得性。以昇腾 910B 八卡裸金属租赁为例,月成本约为同规格进口方案的一个零头,且随时可租;对中小团队更友好。
- 国内云生态完善。华为云、天翼云、阿里云(含昇腾实例)等均已提供开箱即用的国产算力,无需自建机房也能快速起步。
- 生态正快速补齐。torch_npu 2.0、MindIE、vLLM-Ascend、ModelLink 等工具链日趋成熟,主流模型「开箱适配」比例显著提高。
3.2 挑战(必须正视的局限)
- 软件生态仍落后 CUDA 一个身位。CUDA 积累了十余年,大量第三方库(如 FlashAttention、xformers 及众多自定义算子)默认假设 CUDA 环境。迁移到昇腾时,遇到深度定制的 CUDA 核函数,需要用 Ascend C 重写,存在工程量。
- 算子覆盖有「长尾缺口」。主流模型大多能跑,但一些新架构、小众算子可能暂未适配,需要自行补全,带来调试成本。
- 绝对算力与互联带宽的差距。如前表所示,单卡算力、卡间互联(HCCS vs NVLink)仍有差距,直接影响超大规模训练的扩展性。
- 制程与 HBM 的上游约束。国产芯片多采用国产 7nm 级工艺,与全球最先进的 3/4nm 存在代差;高带宽存储的供应也受外部管制影响,这是「硬件能不能更强」的底层瓶颈,非软件能解决。
- 厂商栈碎片化。不同国产厂商各有自己的软件栈,缺乏 CUDA 那样「一处编写、处处运行」的统一标准,跨平台迁移仍有摩擦。
- 人才与社区积累尚浅。熟悉 CANN / 昇腾调优的工程师数量远少于 CUDA 生态,遇到疑难问题时可参考的社区资料相对有限。
四、前景展望:理性乐观,分层看待
综合技术趋势与产业动态,可以这样判断:
- 推理替代:已经成立,且会加速。在「部署上线、对外服务」这一最大需求面上,国产硬件(尤其昇腾、以及多家推理卡)已能稳定平替,并将随着 FP8 等低精度原生支持的普及进一步拉近距离。
- 训练能力:可行且快速追赶。DeepSeek-R1 671B 在昇腾集群上的落地,证明国产硬件已具备大模型级训练/微调能力。随着 torch_npu、MindIE 等工具链成熟,训练门槛会持续下降。
- 「混合架构」将成为务实常态。在合规前提下能拿到的 H20/H200 用于最前沿的探索性训练;绝大多数训练与全部推理由国产硬件承担。这是兼顾「性能」与「安全」的现实路径。
- 长期胜负手在「软件生态 + 制程自主」。硬件参数会持续逼近,但真正决定体验的是:算子覆盖是否齐全、调试是否顺手、跨厂商能否互通;而这一切的上限,又取决于半导体制造与 HBM 等上游环节的突破。
一句话总结:在美国政策限制下,用 CANN(昇腾)或其他国产 GPU/NPU 运行大模型,技术上已经可行,推理场景尤为成熟,训练场景也正快速可用;它的价值在于「把算力的主动权拿回自己手里」,局限在于生态成熟度与最尖端算力仍有差距。它不是魔法,但确实是一条正在越走越宽的可行之路。
📌 想要一份可以直接照做的实操清单? 关注「莱驰云AI实战课堂」,回复关键词 【国产】,免费领取《国产大模型算力替代实操清单》——含硬件速查表、迁移成本分档、部署三步法与常见坑规避。
免责声明:本文为面向公众的技术科普,所涉性能数据为公开资料整理的量级参考,不构成采购或投资依据;出口管制政策处于动态调整中,请以官方最新规则为准。